

Первая модель искусственного интеллекта Elorian хочет рассуждать с изображениями, а не просто о них.
Как стало известно, стартап Elorian , занимающийся разработкой искусственного интеллекта и привлекший 55 миллионов долларов в рамках посевного раунда при оценке в 300 миллионов долларов еще до запуска продукта, в пятницу выпустил свою первую модель.
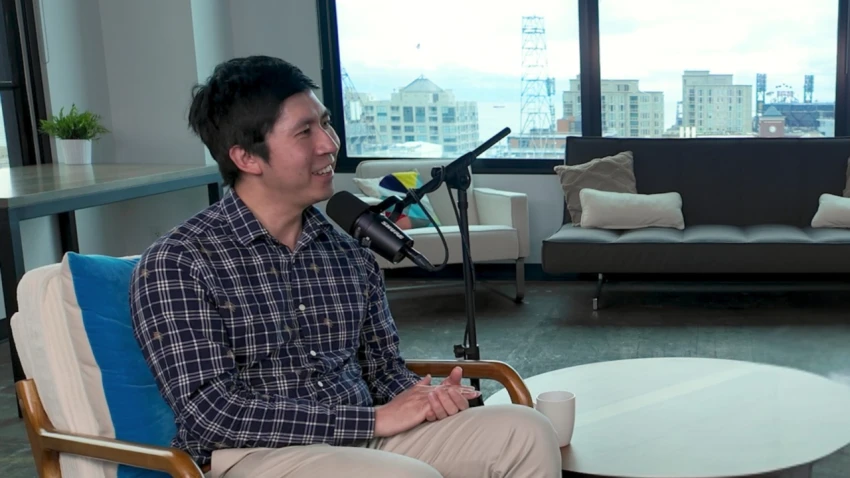
Модель Glimpse запускается в режиме предварительной исследовательской версии с доступом к API и интерфейсом чата. Основная идея? Современные модели ИИ, несмотря на все свои навыки работы с языком и кодом, по-прежнему не умеют по-настоящему видеть.
Большинство мультимодальных моделей анализируют изображение один раз, преобразуют его в токены, а затем обрабатывают его текстом — подобно описанию фотографии по памяти. Glimpse же постоянно возвращается к источнику. В процессе обработки она может обрезать изображение, извлекать определенные кадры из видео или запускать код для измерения или сравнения того, на что она смотрит, — механизм, который Элориан называет «визуальным пространством для анализа». Представьте себе, как кто-то увеличивает изображение на телефоне, чтобы перепроверить увиденное.
Для бывшего исследователя Google DeepMind и генерального директора Elorian Эндрю Дая одним из самых очевидных признаков, которые ИИ до сих пор не мог по-настоящему заметить, стали события, произошедшие во время игровых вечеров.
В прошлом году он сфотографировал настольную игру, в которую только что закончил играть с друзьями, и спросил у модели, кто побеждает. Она не смогла ответить. Настольные игры «имеют свой собственный визуальный язык, свою иконографию, свои символы», — сказал он. «Взрослому человеку довольно легко понять, что происходит, имея минимум текста, но эти модели не способны интуитивно понять, что означают символы».
«Люди могут посмотреть на схемы IKEA без текста и собрать мебель IKEA, верно? Почему модели искусственного интеллекта не могут этого сделать?» — сказал он.
Этот подход не совсем нов — OpenAI добавила функцию обрезки и масштабирования во время рассуждений в свои модели серии o в 2025 году, — но Elorian утверждает, что построила всю модель на его основе, при этом с минимальными затратами. Компания заявляет, что небольшая команда обучила Glimpse на нескольких сотнях графических процессоров, и что модель значительно меньше, чем передовые системы, с которыми она сравнивалась.
Ввод и вывод средств через Glimpse обходится в 0,60 доллара за миллион токенов и 3 доллара за миллион токенов — это дешевле, чем модели среднего уровня, такие как Sonnet и Sol, но дороже, чем облегченные модели, такие как Haiku и Luna.
Однако, согласно оценкам компании Elorian, Glimpse превосходит даже GPT-6 Astra в задачах анализа научных диаграмм и создания субтитров к коротким видеороликам, демонстрируя конкурентоспособные результаты и в других задачах визуального анализа.
Компания Elorian вышла из режима скрытой разработки шесть месяцев назад, проведя раунд финансирования, совместно возглавляемый Striker Venture Partners, Menlo Ventures и Altimeter Capital, при участии Nvidia и главного научного сотрудника Google Джеффа Дина.
Первоначальные цели — компании, располагающие большими объемами видеоматериалов: фирмы, занимающиеся робототехникой, научные лаборатории, медиа-компании и креативные фирмы. В долгосрочной перспективе Elorian хочет перейти от наблюдения к действию. Это означает создание модели сцены на основе этих данных для выбора действий, включая прямое управление роботами. В следующем году, по словам Дая, компания планирует создать «лучшую в мире модель визуального мышления», которая будет лидировать во всех тестах на визуальное мышление.
AMP-версия для быстрого чтения ↗


0 комментариев